
Proyectos
 Proyecto propio · 2026 · IA aplicada · RAG
Ask Leonardo da Vinci
Leonardo da Vinci dejó más de 7.500 páginas escritas. Por primera vez, un software las utiliza para conversar con él sin inventar respuestas. Una red neuronal encuentra, entre 1.565 pasajes de sus cuadernos, los que responden cada pregunta, y el sistema comprueba que cada cita exista en el original.
«Actúa como si fueras…» es uno de los pedidos más comunes que recibe una inteligencia artificial. Cuando se le pide ser alguien, el modelo asegura que puede, pero inventa respuestas, cambia la forma de expresarse de esa persona y opina sobre temas que nunca se planteó. Para no inventar necesitaría muchísimo contexto de esa persona: sus pensamientos, sus experiencias, lo que se preguntó alguna vez. Leonardo lo dejó escrito. Durante toda su vida llenó cuadernos, una transfusión mental a papel: anatomía, óptica, pintura, máquinas, fábulas y hasta sus listas de compras. Sus expresiones, sus respuestas y sus opiniones no hace falta inventarlas: las escribió él.
El sitio recibe al visitante en el taller de Leonardo, sentado frente a él: se le hace una pregunta y responde en primera persona, con las fuentes a la vista. Lo que aparece entre comillas sale tal cual de sus cuadernos. Para quien no sabe qué preguntarle, la Pregunta asistida ofrece un mapa de 22 secciones y 396 temas, y cada uno se convierte en pregunta con un clic. Lo que no está en sus cuadernos no se inventa: el sitio lo aclara. Todo en español y en inglés, con una biblioteca 3D, un museo virtual 3D y un espacio vectorial que muestra cómo funciona por dentro.
Corre sobre un pipeline RAG escrito desde cero, sin frameworks como LangChain o LlamaIndex, para que cada paso se pueda controlar y medir por separado. La pregunta se vuelve vector en el propio navegador; si ningún pasaje se le parece lo suficiente, el sistema se abstiene sin llamar al modelo. Si hay material, una búsqueda híbrida elige tres pasajes, Gemini responde con ellos delante y el código verifica cada cita.
0 de 187
Stack
- Next.js
- React
- TypeScript
- Three.js
- RAG
- Transformers.js
- Gemini API
- Python
La diferencia se mide
Modelo de lenguaje actuando como Leonardo
96,9%156 de 161 citas
Ask Leonardo da Vinci
0%0 de 187 citas
Mismo modelo, mismo prompt y las mismas 120 preguntas. Cada cita se buscó en el texto completo, en los dos idiomas.
| También se midió | Resultado |
|---|---|
| Preguntas con respuesta en los cuadernos que el sistema rechazó por error | 0, en 170 preguntas de prueba |
| Temas de los cuadernos que el buscador encuentra en los dos idiomas | 94% |
evals/out/.Preguntarle a Leonardo
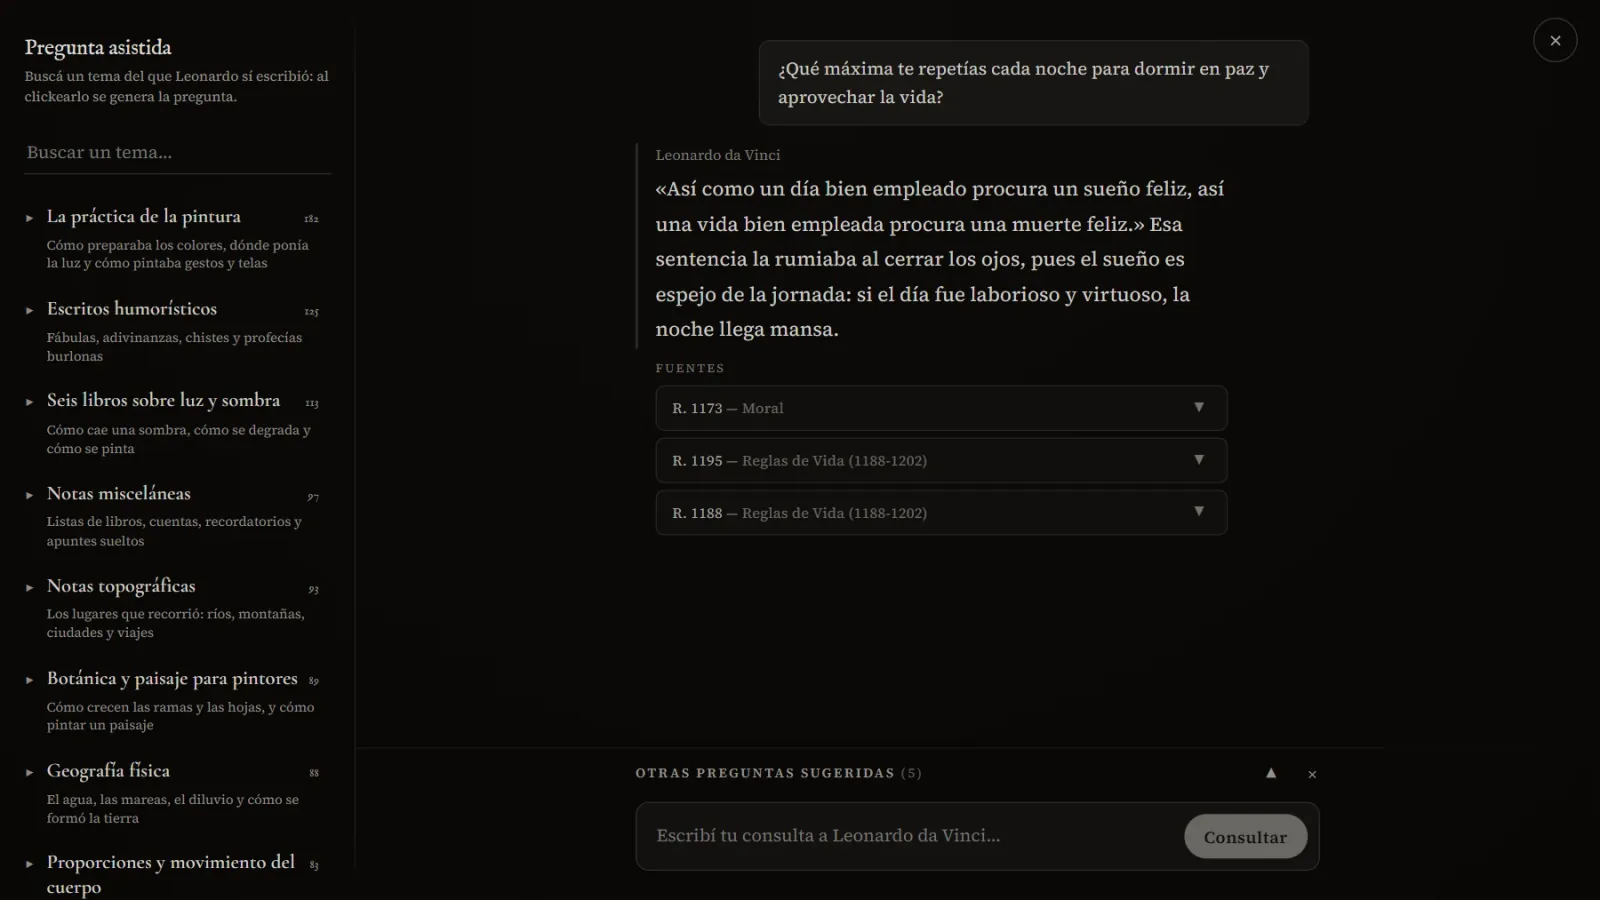
- Respuestas con fuentes. Leonardo responde en primera persona a partir de los pasajes recuperados, con las fuentes debajo y el enlace a cada pasaje en Project Gutenberg.
- Citas textuales. Todo lo que aparece entre comillas sale tal cual de sus cuadernos. Si una cita no coincide con el original, no se muestra como cita.
- Pregunta asistida. ¿Qué se le pregunta a uno de los hombres más brillantes de la historia? Escribió sobre tantas cosas que hasta puede intimidar. Por eso hay un mapa de 22 secciones y 396 temas sobre los que sí escribió, más seis preguntas sugeridas: se elige un tema y con un clic se convierte en pregunta. Quien no está acostumbrado a la IA puede concentrarse en leer las respuestas en vez de armar un prompt.
- Lo que no pudo escribir. Hay cosas que Leonardo, lógicamente, no dejó en sus cuadernos, como su propia muerte, y datos que no solía anotar sobre sí mismo («¿qué día naciste?», «¿quién fue tu maestro?»). Ahí el sitio lo aclara y muestra el fragmento exacto de Wikipedia, con su atribución, fuera de su voz.
- Lo que se perdió. Con los siglos, parte de sus cuadernos se perdió. ¿La Mona Lisa? Sus manuscritos nunca la mencionan, y el sitio muestra la nota del editor que lo confirma. Queda el misterio, pero no se inventa.
- Bilingüe. Todo el sitio, incluidas las respuestas de Leonardo, está completo en español y en inglés.
Biblioteca 3D
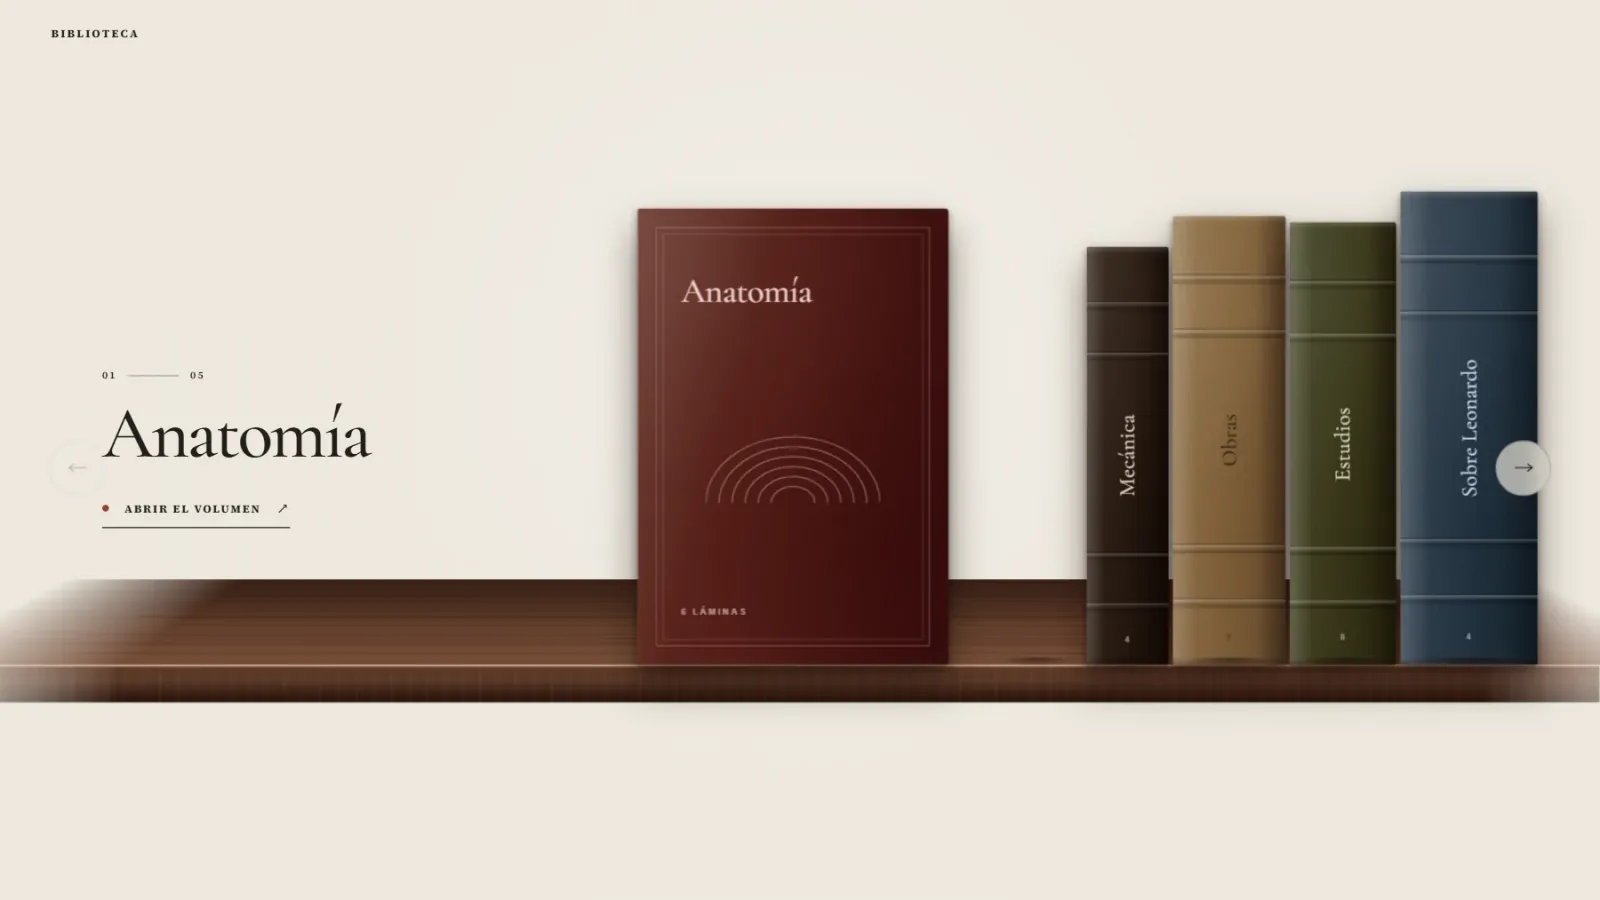
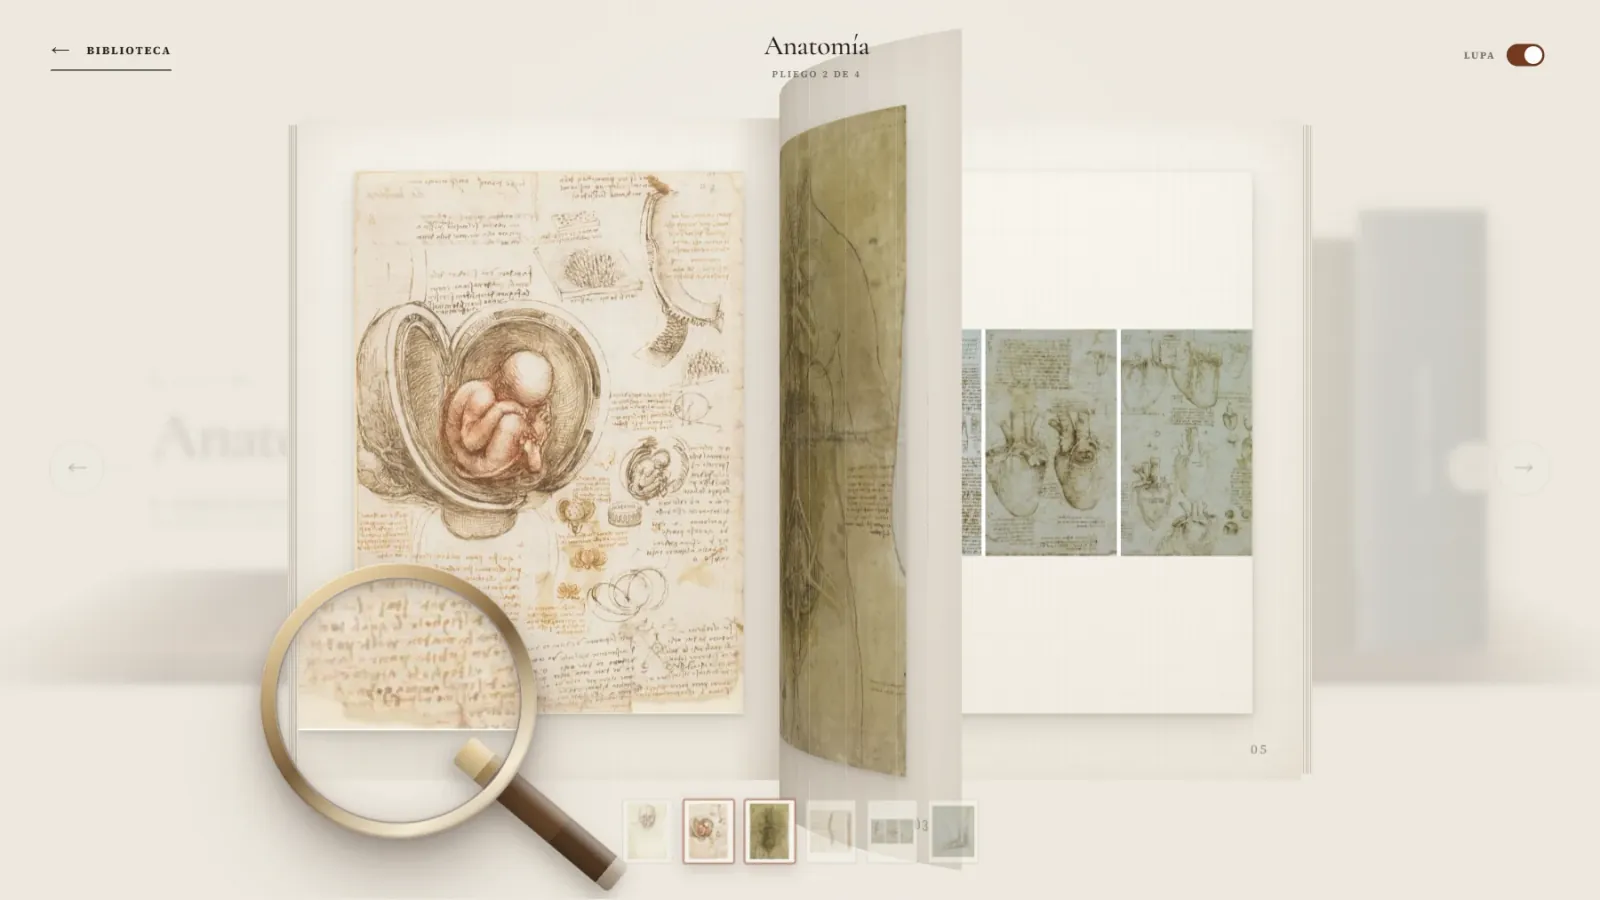
Cinco volúmenes con 27 láminas de Leonardo. Los tomos salen del estante, las hojas se pasan con el pliegue de un libro real y, en escritorio, una lupa permite leer la escritura de cerca.
Museo virtual 3D
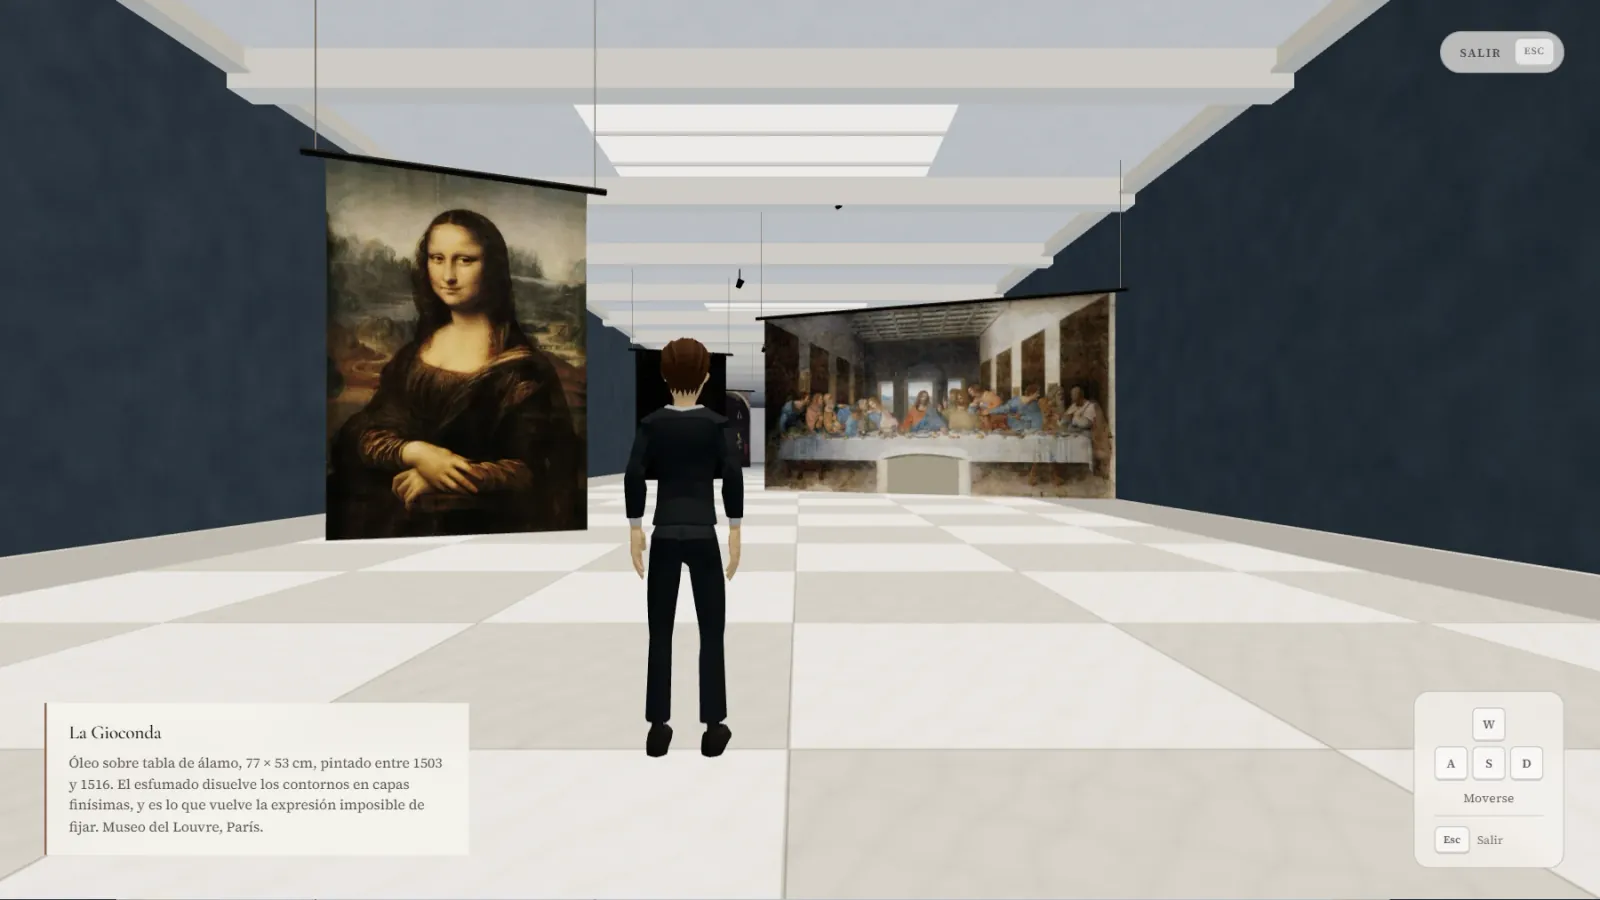
Una sala que se recorre caminando, también desde el teléfono, con nueve de sus obras y la ficha de cada una.
Espacio vectorial
Sección encendida…
1.402 pasajes · 22 secciones · 384 → 3 dimensiones
Es la sección «Cómo funciona» del sitio. Le muestra al visitante los pasajes convertidos en vectores y cómo una pregunta encuentra los suyos. Está en una web para público general a propósito: la validez técnica del sistema es lo que respalda cada respuesta de Leonardo.
No es una animación ilustrativa. Son los vectores reales del proyecto: los 1.402 pasajes que consulta el sistema, ubicados por su red neuronal y llevados de 384 dimensiones a 3 para poder verlos. Al encender una sección se entiende la cercanía: para la red neuronal, los pasajes que hablan de lo mismo tienden a quedar juntos.
Arquitectura
La idea fue el punto de partida, no el resultado. Hubo que medir y elegir modelos, calibrar la búsqueda semántica, dejar que hable sólo Leonardo (y no su editor), limitar la prosa que los modelos de IA tienden a inventar y comprobar que cada cita exista en los cuadernos. El texto que consulta el sistema es la edición que Jean Paul Richter transcribió y tradujo en 1888, hoy de dominio público.
- Preguntaembedding en el navegadorSe vuelve vector en el dispositivo de quien pregunta, sin API.
- Casos curadoscapa 0Lo que se sabe que no está en los cuadernos: abstención con la evidencia citada.
- Umbral de similitudcapa 1Si ningún pasaje se le parece lo suficiente, se abstiene sin llamar al modelo.
- Recuperación híbridacoseno + BM25 · RRFElige los tres pasajes que van a sostener la respuesta.
- Generacióncapa 2 · GeminiEl modelo responde, o se abstiene, con los pasajes delante.
- Verificacióncapa 3 · códigoCada cita se compara con el pasaje original.
- Respuestacon sus fuentesEn la voz de Leonardo, con los pasajes a la vista.
En dos de los pasos el sistema puede abstenerse antes de llamar al modelo: prefiere decir que los cuadernos no tratan un tema antes que inventar una respuesta.
- El coseno decide y la fusión sólo ordena. Un ranking siempre tiene un primer puesto, exista o no material pertinente; lo que determina si hay respuesta es la similitud contra un umbral calibrado.
- Un índice y un umbral por idioma. Con un umbral compartido, la exactitud del filtro caía de 88,4% a 70,5%.
- Embeddings en el navegador. La consulta se vectoriza en el dispositivo del usuario: sin costo por consulta y sin una cuota que se pueda agotar.
- Sin servidor persistente ni base de datos vectorial. El índice es un binario int8 versionado en Git, BM25 está precomputado y las secciones 3D se cargan sólo cuando alguien las visita.
Stack
| Capa | Tecnología |
|---|---|
| Frontend | Next.js 16 (App Router), React 19, TypeScript, Three.js |
| Embeddings | multilingual-e5-small (384 dimensiones, int8) · Transformers.js en el navegador |
| Recuperación | Coseno denso + BM25 precomputado, fusión RRF |
| Generación | Gemini 3.1 Flash-Lite, con GPT-OSS 120B en Groq como respaldo |
| Ingesta | Python: parseo de la edición de Gutenberg, separación de voces, chunking, embeddings y calibración |
| Evaluación | 170 preguntas en 8 categorías · juez automático validado contra etiquetado humano |
| Seguridad | Cloudflare Turnstile, límite por IP hasheada y presupuesto diario global |
| Hosting y CI | Vercel · GitHub Actions |
 Proyecto propio · 2026 · Datos · ETL
Datos Pauta Oficial
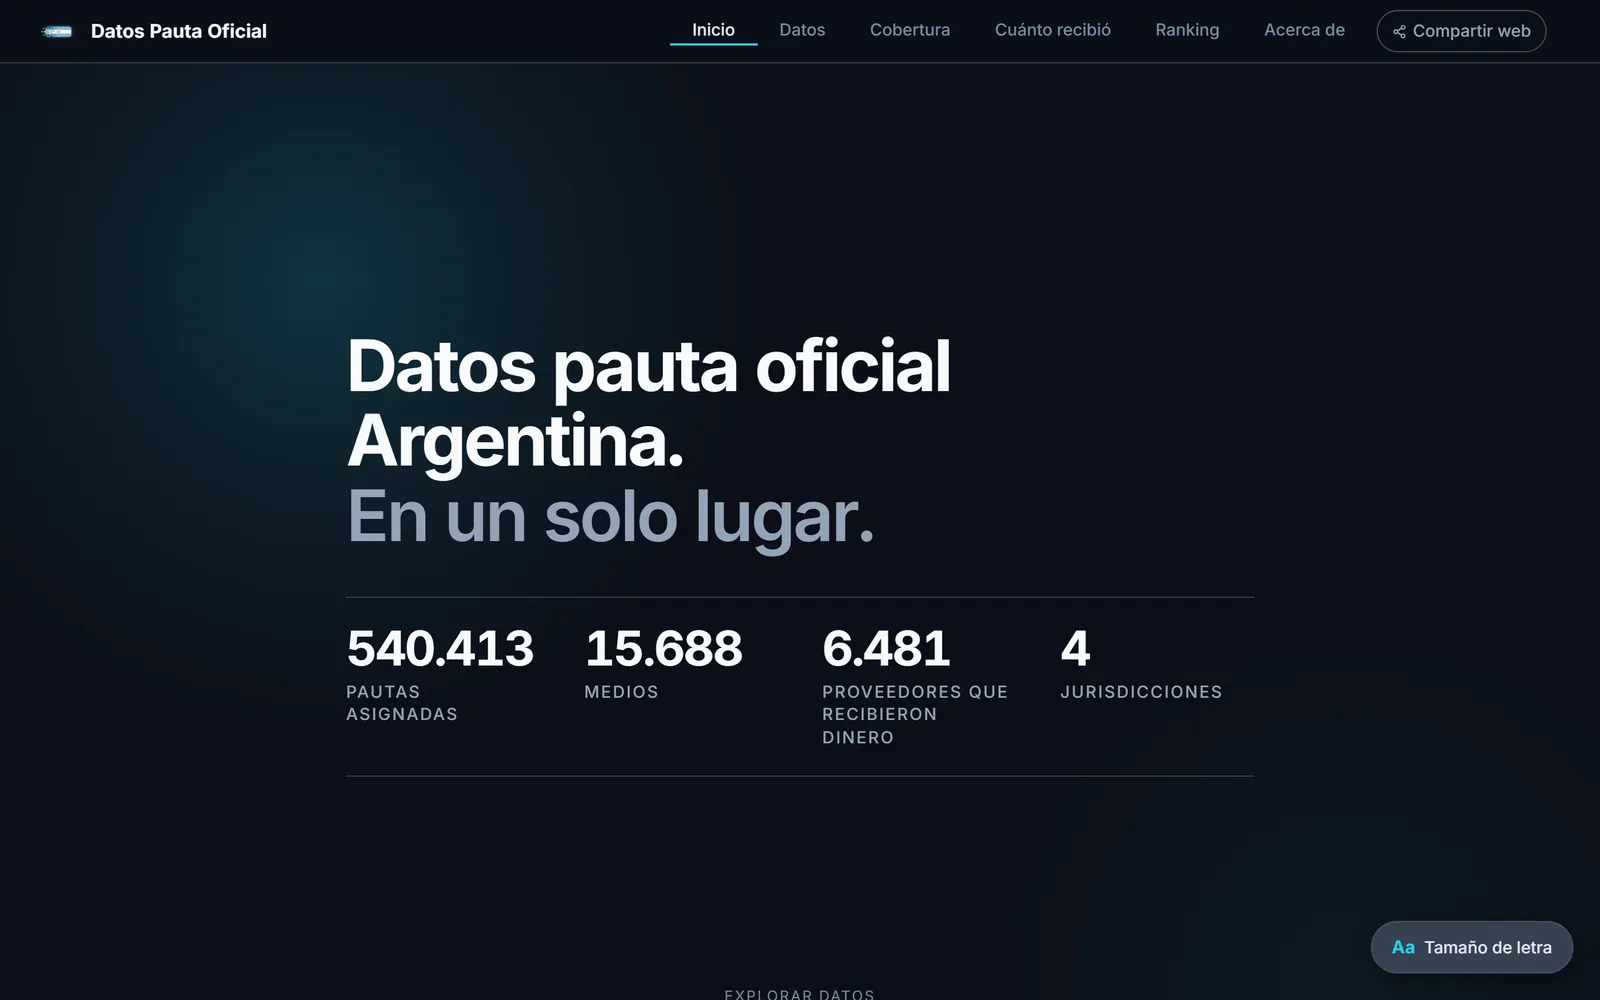
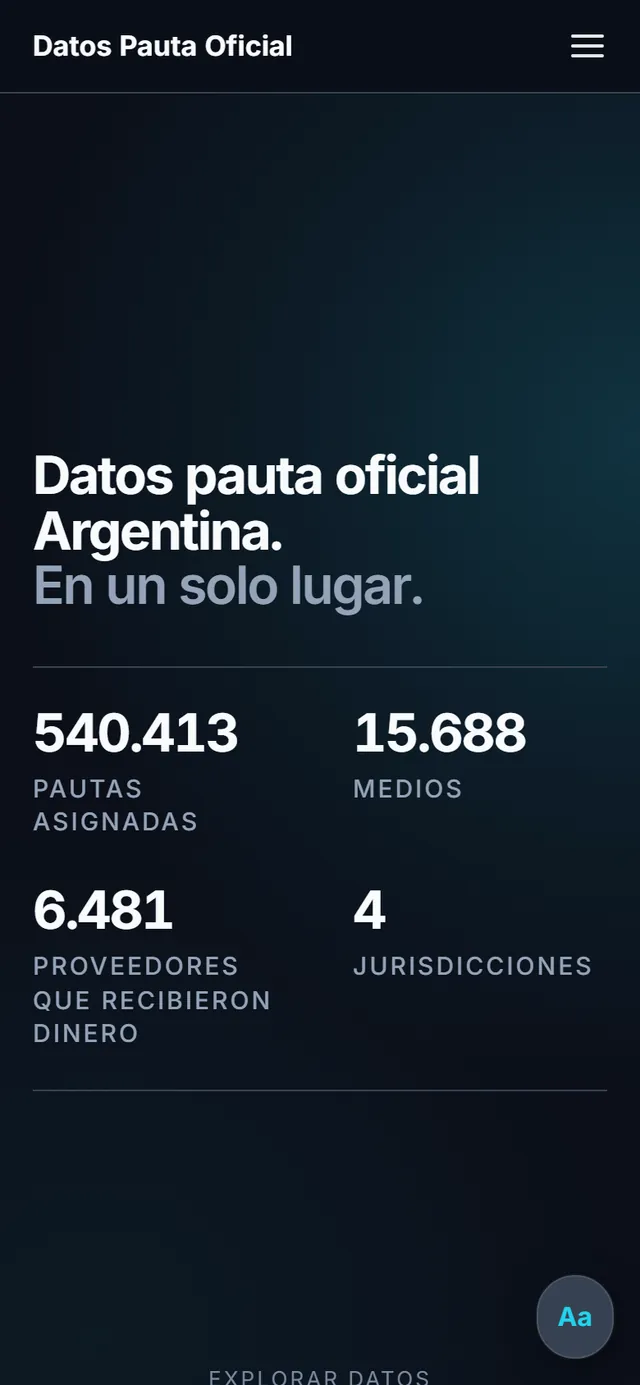
La primera y única base unificada de pauta oficial argentina: 540.413 órdenes de publicidad de Nación, CABA, PBA y Santa Fe (2003–2025), con montos deflactados por IPC. Se consulta desde el sitio con una tabla explorable, rankings y el buscador «Cuánto recibió» (por proveedor, medio o grupo mediático), con la metodología publicada.
Antes, esos datos estaban dispersos en portales, planillas y PDF de cada jurisdicción, sin una forma unificada y sencilla de acceder a ellos ni de compararlos. El ETL en Python incluye un dataset de PBA 2020–2024 reconstruido a partir de más de 500 resoluciones en PDF, datos que no existen en ningún portal de datos abiertos.
Arquitectura sin backend: la base SQLite (~173 MB) se aloja en Cloudflare R2 y el navegador consulta únicamente los bytes necesarios mediante HTTP Range Requests.
540.413
Stack
- Python
- ETL
- SQLite
- Astro
- React
- TypeScript
- Cloudflare R2/Pages
PBA, reconstruida desde PDF
La Provincia de Buenos Aires no publica sus órdenes de publicidad de 2020 a 2024 en datasets abiertos: la información estaba en resoluciones individuales en PDF. Un script fue extrayendo los datos resolución por resolución (más de 500) para reconstruir el detalle de cada orden: proveedor, medio, monto y expediente. Ese tramo es un dataset propio del proyecto.
Cobertura
PBA 2020–2024 · Reconstruido de más de 500 resoluciones en PDF
540.413 órdenes en total, 2003–2025
| Jurisdicción | Período | Órdenes |
|---|---|---|
| Nación | 2009–2022 | 225.367 |
| CABA | 2003–2024 | 209.877 |
| Santa Fe | 2008–2023 | 61.187 |
| PBA | 2020–2025 | 43.982 |
| Total | 2003–2025 | 540.413 |
Arquitectura
El proyecto corre sin backend ni servidores: la base SQLite completa (~173 MB) vive en Cloudflare R2 partida en bloques, y el navegador consulta sólo los bytes que necesita mediante HTTP Range Requests, gracias a sql.js-httpvfs.
- Fuentes oficialesCSV · Excel · PDFCada jurisdicción publica a su manera.
- ExtracciónPythonUn extractor por jurisdicción.
- Unificaciónunificar.py · validar.pyUn solo CSV canónico y validado: 8 columnas, 540.413 filas.
- Base de datosbuild_db.py · SQLiteMontos deflactados por IPC (INDEC) y cachés precomputados.
- AlmacenamientoCloudflare R2La base, partida en bloques de 20 MiB.
- Consultasql.js-httpvfsSQL desde el navegador, que pide sólo los bloques que necesita.
- SitioAstro · React · Cloudflare PagesEstático, con islas de React: sin backend ni servidores.
Funcionalidades
- Tabla explorable de 540 mil órdenes. Filtros cruzados por jurisdicción y año, agrupación por proveedor o medio con filas expandibles. El estado inicial viene precomputado en el HTML, y la base se abre recién cuando el usuario interactúa. El dato que se muestra es el crudo exacto de la fuente oficial.
- «Cuánto recibió». Buscador por proveedor, medio o grupo mediático; el modo grupo consolida las razones sociales de cada holding según el Media Ownership Monitor Argentina, con fuente citada. Genera una imagen de 1080 × 1080 para compartir, con Canvas puro, y enlaces que restauran la búsqueda.
- Rankings de proveedores, medios y grupos por jurisdicción y año, servidos desde caches precomputados en el build.
- Metodología pública: fuentes, criterios de deflactación y de normalización documentados en el sitio.
Decisiones de datos
- Montos deflactados, no nominales. Todo está en pesos constantes (IPC INDEC): comparar la pauta de 2009 con la de 2024 en pesos nominales no tiene sentido en Argentina.
- El dato exacto, aun a costa de la comodidad. La tabla muestra cada orden tal como figura en la fuente oficial, sin corregir ni agrupar nombres, aunque eso la haga menos cómoda de leer: un mismo proveedor puede aparecer escrito de varias formas. Los rankings y «Cuánto recibió» sólo unifican variantes de escritura de una misma razón social, con un listado curado de forma conservadora; la consolidación por grupo mediático es una opción aparte, con su fuente citada.
- Honestidad sobre los huecos. Cada limitación de la fuente (filas sin fecha, períodos parciales) se documenta en vez de ocultarse.
- Postura informativa: sin denuncia ni opinión.
Stack
| Capa | Tecnología |
|---|---|
| ETL | Python: extractores por jurisdicción, unificación y validación |
| Base de datos | SQLite estática, consultada desde el navegador con sql.js-httpvfs |
| Framework | Astro 6 (salida estática) + React 19 (islas) |
| Lenguaje | TypeScript |
| Búsqueda | MiniSearch (índice en el cliente) |
| Hosting | Cloudflare Pages + Cloudflare R2 |
| Deflactación | IPC INDEC, montos en pesos constantes |
 Freelance · dic. 2025 – jun. 2026 · Full stack
SeViVe
Aplicación de reservas y gestión para un estudio de pilates, en producción con más de 200 usuarios. Los alumnos reservan sus clases desde el celular y la administración gestiona el estudio desde su panel. API REST en Python/FastAPI y PostgreSQL.
La desarrollé como único programador para un estudio de Canning, Buenos Aires (franquicia), desde la definición de requisitos con el cliente hasta la puesta en producción. Finalizado el desarrollo, continúo a cargo del soporte, la administración del servidor y las actualizaciones solicitadas por el cliente.
Reservas con control de concurrencia para evitar sobrerreservas, créditos con vencimiento, turnos fijos con reserva automática, toma de asistencia y calendario con feriados configurables. Las cuentas que crea la administración se unifican automáticamente con la del alumno cuando se registra (por DNI), preservando historial, créditos y turnos.
Se instala como PWA en cualquier dispositivo, con una guía paso a paso pensada para usuarios no técnicos.
+200
Stack
- Flutter
- Python
- FastAPI
- PostgreSQL
- Firebase
- Docker
- Nginx
Qué resuelve
El objetivo: una aplicación fácil de usar, que permita delegar y ordenar la gestión del estudio, y que al mismo tiempo impida que un alumno rompa el orden del negocio.
- Reservas con control de concurrencia. El backend valida cupos, créditos y horarios en cada reserva: dos alumnos no pueden quedarse con el mismo último lugar.
- Turnos fijos y clases recurrentes. La administración crea una clase una vez y el sistema genera las instancias semanales respetando los feriados; los abonos se reservan solos cada semana.
- Créditos con vencimiento, descontados automáticamente con cada reserva, y cancelación con política de sanciones por aviso tardío o ausencia.
- Fusión de cuentas por DNI. La administración puede cargar alumnos que todavía no tienen la aplicación, para que los cupos y las estadísticas sean reales. Cuando ese alumno se registra con su DNI, las dos cuentas se unifican y conserva turnos fijos, créditos e historial.
- Asistencia. La administración la toma desde la agenda del día, y el calendario mensual guarda cada clase dictada con su ocupación y su asistencia.
- Panel de administración: historial por alumno, bloqueo de usuarios con cancelación de sus reservas futuras, pausa general de las reservas y feriados que se cargan desde la aplicación, sin un nuevo despliegue.
- Comunicación: novedades con notificaciones push y feedback después de cada clase, con aviso por email a la administración ante una respuesta negativa.
- Apto médico: carga de PDF o imagen, con compresión automática.
- Rifa mensual entre alumnos activos, ponderada por asistencia, para incentivar la constancia.
- Instalación sin tienda de aplicaciones. Es una PWA: se instala desde el navegador en el teléfono, la tablet o la computadora, con una guía paso a paso pensada para usuarios no técnicos.
Arquitectura
- Reservas con control de concurrencia
- Créditos con vencimiento
- Turnos fijos con reserva automática
- Fusión de cuentas por DNI
Una sola aplicación en Flutter (Riverpod, Freezed, GoRouter) para alumnos y administración, servida como PWA. El inicio de sesión es el de Google, mediante Firebase, y el backend verifica esa identidad en cada pedido.
Nginx recibe el tráfico por HTTPS, limita los pedidos por dirección IP y sirve la aplicación y los archivos subidos. Detrás, la API asíncrona en FastAPI (SQLModel, asyncpg) trabaja sobre PostgreSQL 16, con los cambios de estructura versionados en Alembic. Las notificaciones push salen por Firebase Cloud Messaging.
Todo corre en tres contenedores de Docker Compose (base de datos, API y Nginx) en un VPS que administro: despliegue con un script que aplica las migraciones, backups y resolución de fallas.
Stack
| Capa | Tecnología |
|---|---|
| App | Flutter 3, Riverpod, Freezed, GoRouter, Dio · instalable como PWA |
| Backend | Python, FastAPI (async), SQLModel, asyncpg |
| Base de datos | PostgreSQL 16, Alembic |
| Autenticación | Firebase Authentication (Google) |
| Archivos y avisos | Firebase Storage, Firebase Cloud Messaging |
| Infraestructura | Docker Compose, Nginx, VPS en Hetzner |
 Proyecto propio · 2026 · IA · Automatización
Inversiones en Argentina
Automatiza con IA el seguimiento de las inversiones privadas en Argentina. Identifica las inversiones reales, descarta duplicados y publica los resultados en la web y en un canal de Telegram.
La información estaba dispersa en noticias, cuentas de X y registros oficiales, y cada inversión aparece repetida en muchos medios, escrita de formas distintas. Un flujo programado en GitHub Actions reúne esas fuentes y suma una búsqueda en Google con Gemini y Search Grounding.
Un sistema de capas decide qué llega a publicarse: Gemini estructura cada mención, reglas deterministas y Jev (TypeSafe) separan las inversiones reales de lo que no lo es, y pgvector recupera los registros parecidos. El mismo proyecto, contado por dos medios, puede leerse muy distinto, y dos proyectos distintos de la misma región pueden parecer casi idénticos: por eso la similitud sólo sugiere candidatos, y la decisión la toman reglas de identidad y un modelo de decisión (Jev). API en FastAPI y frontend en Next.js con render en servidor, sobre Vercel.
Stack
- Python
- FastAPI
- Gemini
- Jev (TypeSafe)
- PostgreSQL/pgvector
- GitHub Actions
- Next.js
El flujo de cada corrida
- FuentesX · RSS · RIGICuentas especializadas, medios por rubro y el registro oficial.
- FiltrodeterministaSaca el ruido: menos tokens y decisiones más simples después.
- ExtracciónGemini + GroundingCada mención pasa a datos estructurados.
- ValidaciónreglasFuera deuda, préstamos, compraventa de acciones y lanzamientos.
- JuicioJev (TypeSafe)¿Es una inversión privada concreta?
- Deduplicaciónpgvector + identidadLa similitud recupera; la identidad decide.
- Publicaciónweb · TelegramSólo lo nuevo, sin intervención.
Cada capa descarta algo y le deja a la siguiente menos ruido y menos margen de error. Sin Jev, el flujo funciona igual sobre sus capas deterministas.
- Recolección. Cuentas especializadas de X (API de Apify), medios de distintos rubros por RSS, paginados hasta cubrir la ventana completa, y el registro oficial del RIGI (el régimen de incentivo a las grandes inversiones) de forma incremental: se guarda una huella de cada proyecto y sólo se reenvían los nuevos o los que cambiaron.
- Filtro de relevancia. Un filtro determinista descarta el ruido estructural de los feeds antes de que llegue a Gemini. No sólo ahorra tokens: los pasos siguientes reciben menos material irrelevante, y sus decisiones son más simples y con menos margen de error. Prioriza no perder: ante la duda deja pasar, porque descartar de más significa perder una inversión real.
- Extracción con Gemini y Search Grounding. El material recolectado entra como primera fuente y Gemini busca en Google noticias del período como segunda, con foco en los rubros que las fuentes propias cubren poco. Devuelve cada inversión como JSON estructurado.
- Validación. Una red determinista descarta lo que no es una inversión productiva nueva: emisiones de deuda, préstamos, constituciones de sociedades, compraventa de acciones, contratos ganados por proveedores y lanzamientos de productos.
- Juicio semántico con Jev. Un modelo que devuelve decisiones tipadas con probabilidad calibrada, en lugar de texto, responde si cada registro es una inversión privada concreta.
- Deduplicación. El embedding recupera los candidatos más parecidos; la decisión la toman reglas de identidad y Jev, respondiendo si dos registros describen el mismo proyecto.
- Publicación y parte de estado. Lo nuevo se guarda y se publica a la vez en la web y en Telegram. Cada corrida termina informando el estado de cada fuente, y falla si alguna que debería responder no trajo nada.
Por qué la similitud recupera pero no decide. Sobre un corpus temáticamente estrecho, el espacio vectorial se comprime. Dos proyectos distintos del mismo rubro y la misma región pueden parecerse tanto como el mismo proyecto contado por dos medios, y no hay un umbral que separe esos dos casos.
Funcionalidades
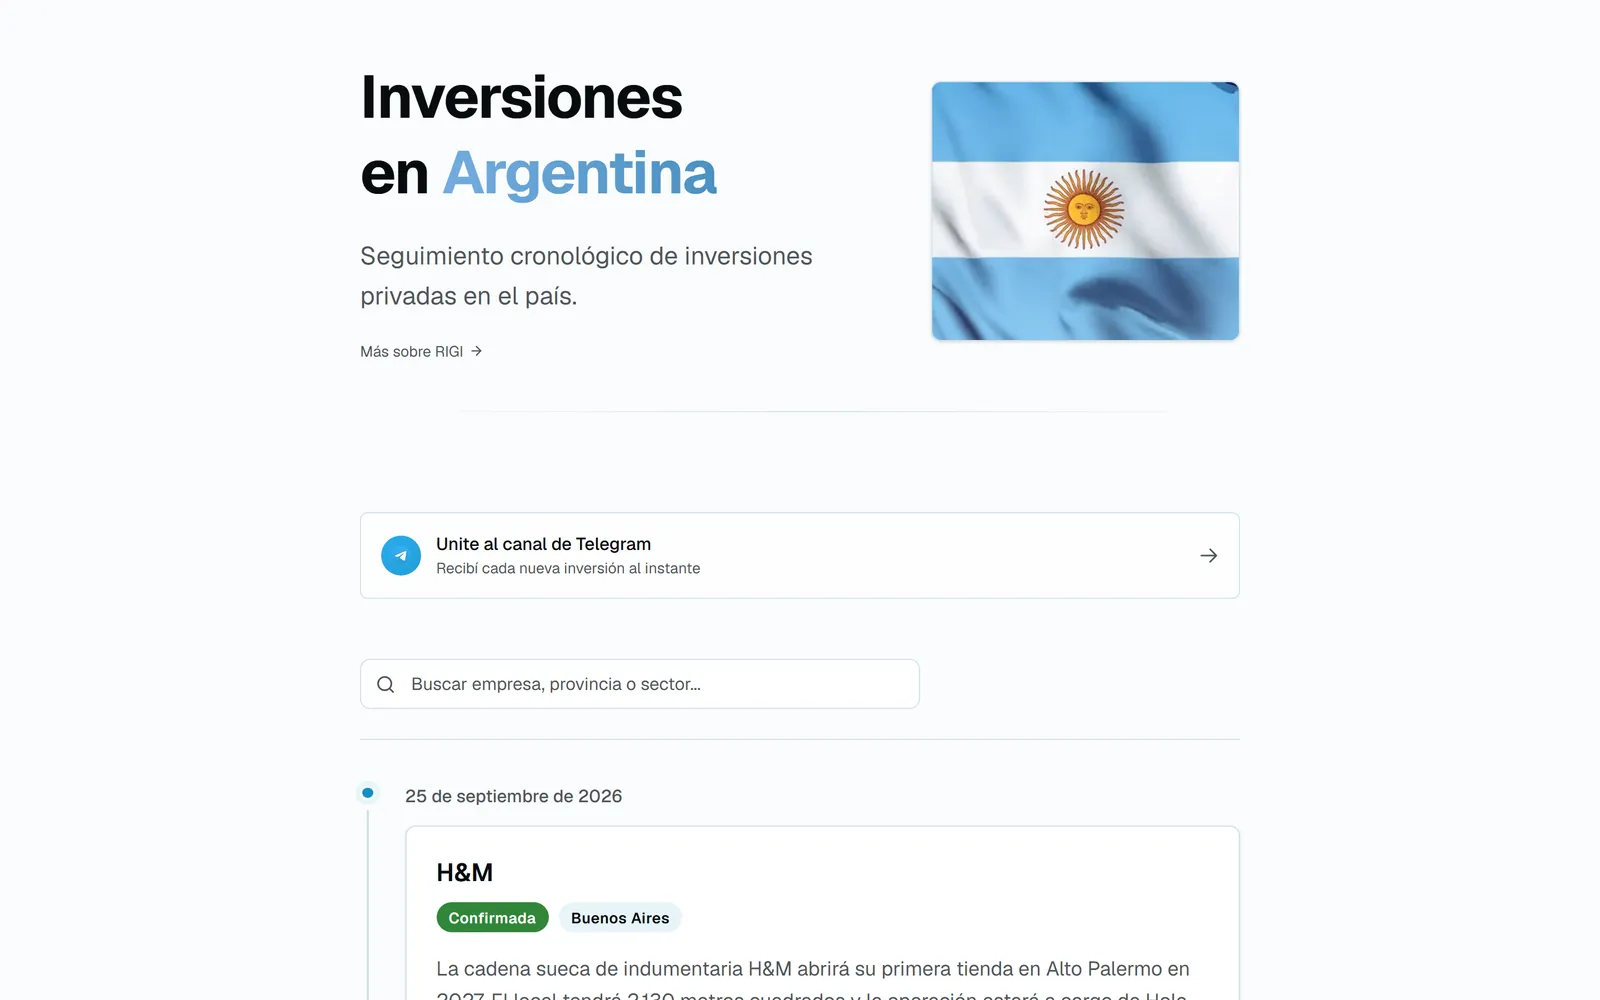
- Cronología interactiva ordenada por fecha de anuncio, con el estado de cada inversión (confirmada, anunciada o en evaluación), montos legibles (USD 40M, USD 1.2B), provincia y empleos cuando están disponibles.
- Búsqueda en tiempo real sobre empresa, descripción y ubicación, sin importar las tildes: «Neuquen» encuentra las inversiones de Neuquén.
- Indexable: la primera página se renderiza en el servidor, con datos estructurados (JSON-LD),
sitemap.xmlyrobots.txt. - API REST en FastAPI con documentación automática.
Stack
| Capa | Tecnología |
|---|---|
| Automatización | GitHub Actions (cada 72 horas) |
| Fuentes | Apify (X), RSS de medios, registro oficial del RIGI |
| IA generativa | Gemini 2.5 Flash con Google Search Grounding |
| Juicio semántico | Jev (TypeSafe) |
| Embeddings | gemini-embedding (768 dimensiones) |
| Base de datos | PostgreSQL (Neon) con pgvector y unaccent |
| API | Python, FastAPI (async), Mangum, sobre Vercel |
| Frontend | Next.js 16 con render en servidor, TypeScript, Tailwind CSS, Framer Motion |
| Publicación | Telegram Bot API |
 Proyecto propio · 2026 · Visión por computador
FaceHunt 2
Sistema de reconocimiento facial con IA y deep learning que, a partir de una foto, localiza cada aparición de una persona en horas de video, incluso de perfil, parcialmente cubierta o en baja resolución.
Procesa todo en local con aceleración por GPU, sin enviar datos a la nube. Es una aplicación de escritorio que devuelve los intervalos de tiempo exactos, con miniatura, mini-clip y acceso directo a cada momento, para un archivo local o un video de YouTube. Aplicable a seguridad, investigación y análisis de video.
Reconocimiento facial con InsightFace (ArcFace, embeddings de 512 dimensiones) sobre ONNX Runtime, con aceleración por GPU según el hardware disponible y seguimiento entre cuadros. Es la reconstrucción integral de la primera versión, FaceHunt (2025): de TensorFlow en CPU a ONNX Runtime con GPU.
7 s
Stack
- Python
- InsightFace
- ArcFace
- ONNX Runtime
- FastAPI
- pywebview
- pytest
Qué hace
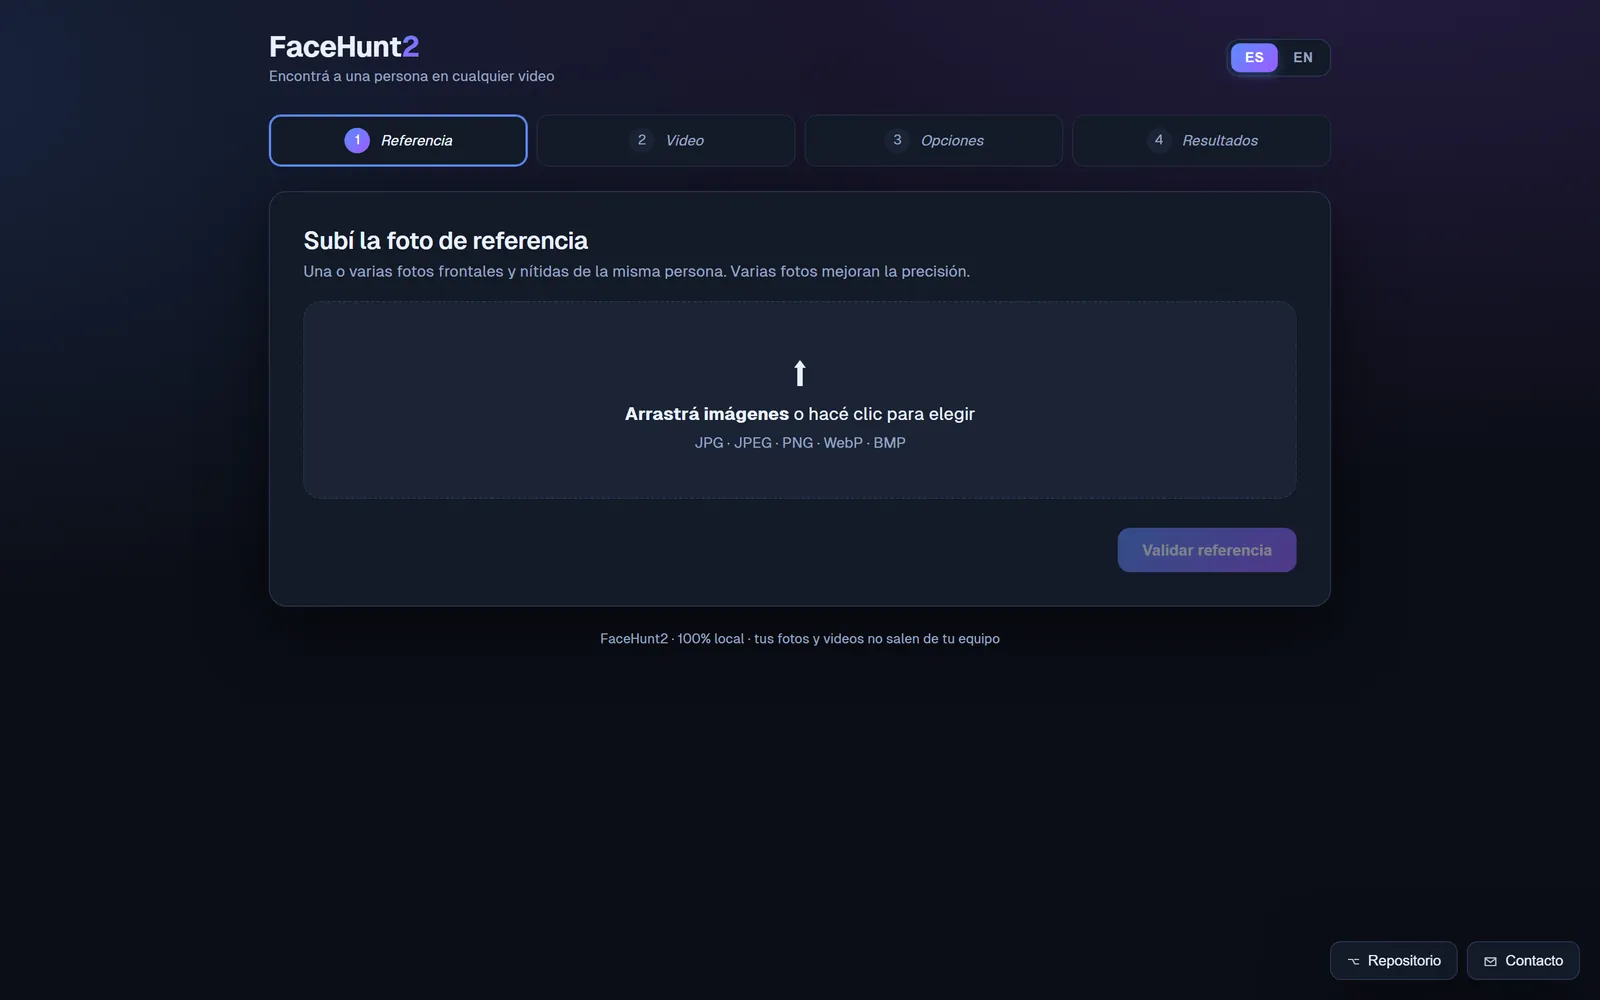
Se cargan una o varias fotos de la persona y un video (archivo local o URL de YouTube). La aplicación devuelve los rangos de tiempo exactos en los que aparece, cada uno con una miniatura del rostro, un mini-clip animado del momento y un salto directo, más una línea de tiempo del video completo en la que se puede hacer clic.
Cómo funciona una búsqueda
- Referencia. Se validan las fotos y se calcula un embedding de 512 dimensiones por rostro; con varias fotos se promedian, para una identificación más estable.
- Video. Se valida el archivo o la URL (YouTube se descarga con yt-dlp).
- Análisis en segundo plano. Un hilo productor lee los cuadros y otro los analiza: detección con SCRFD, comparación por coseno contra la referencia y seguimiento de cada rostro entre cuadros.
- Progreso en vivo. El avance, el tiempo restante y las coincidencias llegan por Server-Sent Events, y la búsqueda se puede cancelar en cualquier momento.
- Resultados. Las coincidencias se agrupan en rangos, cada uno con su miniatura, su mini-clip y su enlace.
Características
- 100% local y privado. Las fotos y los videos nunca salen del equipo: no hay servidor en línea ni subida a la nube.
- Reconocimiento facial actual. InsightFace
antelopev2(SCRFD-10G + ArcFace ResNet100 entrenado en Glint360K, embeddings de 512 dimensiones) sobre ONNX Runtime, con flip-TTA para no perder apariciones. - Aceleración por GPU automática. Elige el mejor proveedor disponible (CUDA, DirectML o CPU): funciona con placas NVIDIA, AMD e Intel en Windows.
- Seguimiento temporal. Agrupa los rostros en tracklets entre cuadros y compara contra el embedding agregado, lo que recupera apariciones en cuadros degradados (de perfil, tapadas o en baja resolución).
- Dos modos: rápido (2 cuadros por segundo) y exhaustivo (5 cuadros por segundo y rostros más chicos).
- Ejecutable de un clic para Windows, con tests de la lógica pura en pytest.
De FaceHunt a FaceHunt 2
| FaceHunt (2025) | FaceHunt 2 (2026) | |
|---|---|---|
| Motor | TensorFlow en CPU | ONNX Runtime con GPU (CUDA, DirectML o CPU) |
| Modelo | FaceNet, 128 dimensiones | ArcFace ResNet100, 512 dimensiones |
| Resultado | Marcas de tiempo sueltas | Rangos con miniatura, mini-clip y línea de tiempo |
| Uso | Interfaz web: demo en Hugging Face Spaces o imagen de Docker | Aplicación de escritorio de un clic, sin servidor ni nube |
Stack
| Capa | Tecnología |
|---|---|
| Reconocimiento | InsightFace (SCRFD + ArcFace), ONNX Runtime |
| Video | OpenCV, yt-dlp |
| Backend | Python, FastAPI, Server-Sent Events |
| Interfaz | HTML, CSS y JavaScript sin build, en una ventana pywebview |
| Pruebas y empaquetado | pytest, PyInstaller, instalador para Windows |
Primera versión
FaceHunt 2025
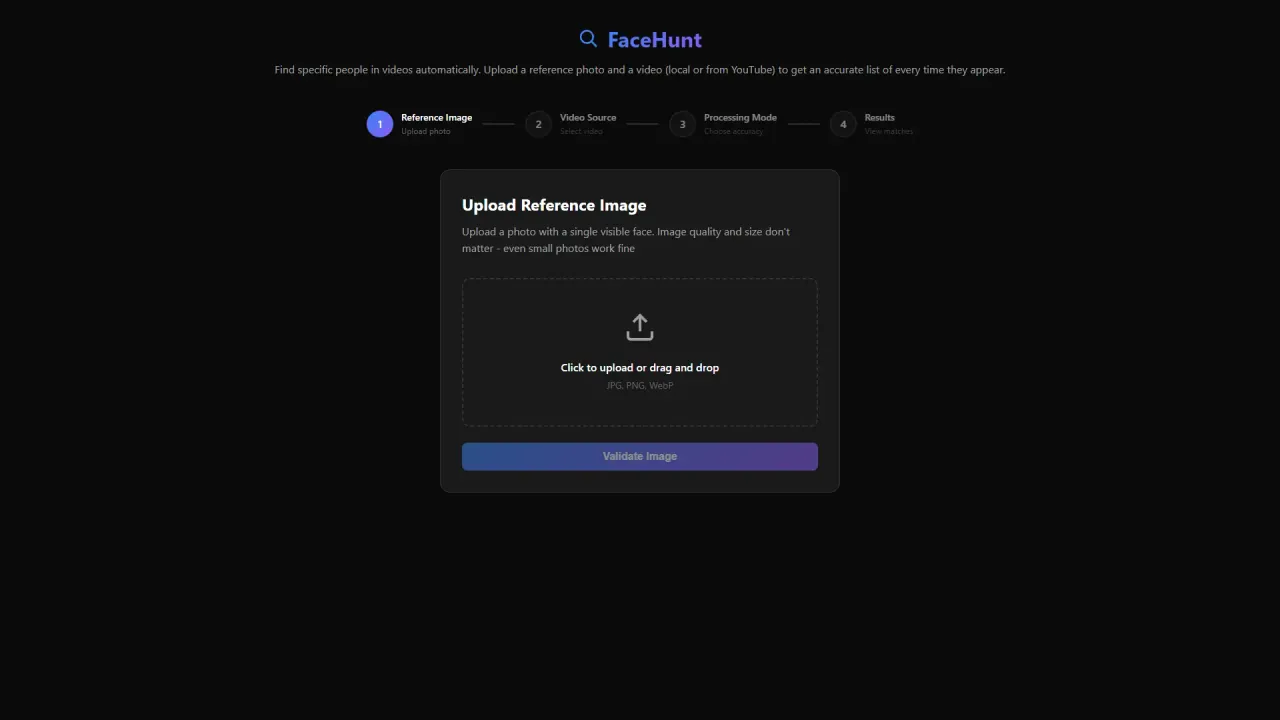
Reconocimiento facial en video con deep learning: DeepFace (FaceNet) con dos modos de análisis (alta precisión con RetinaFace, equilibrado con MTCNN), extracción de cuadros por lotes con OpenCV y descarga de YouTube con yt-dlp. Empezó como aplicación de escritorio en Tkinter y sumó una API en FastAPI con interfaz web por pasos. Se publicó como demo web en Hugging Face Spaces y como imagen en Docker Hub, y corre en Windows, macOS y Linux.
- Python
- DeepFace
- FaceNet
- RetinaFace
- FastAPI
- Docker
- Hugging Face Spaces
 Proyecto propio · 2026 · Extensión de Chrome
MementoLife
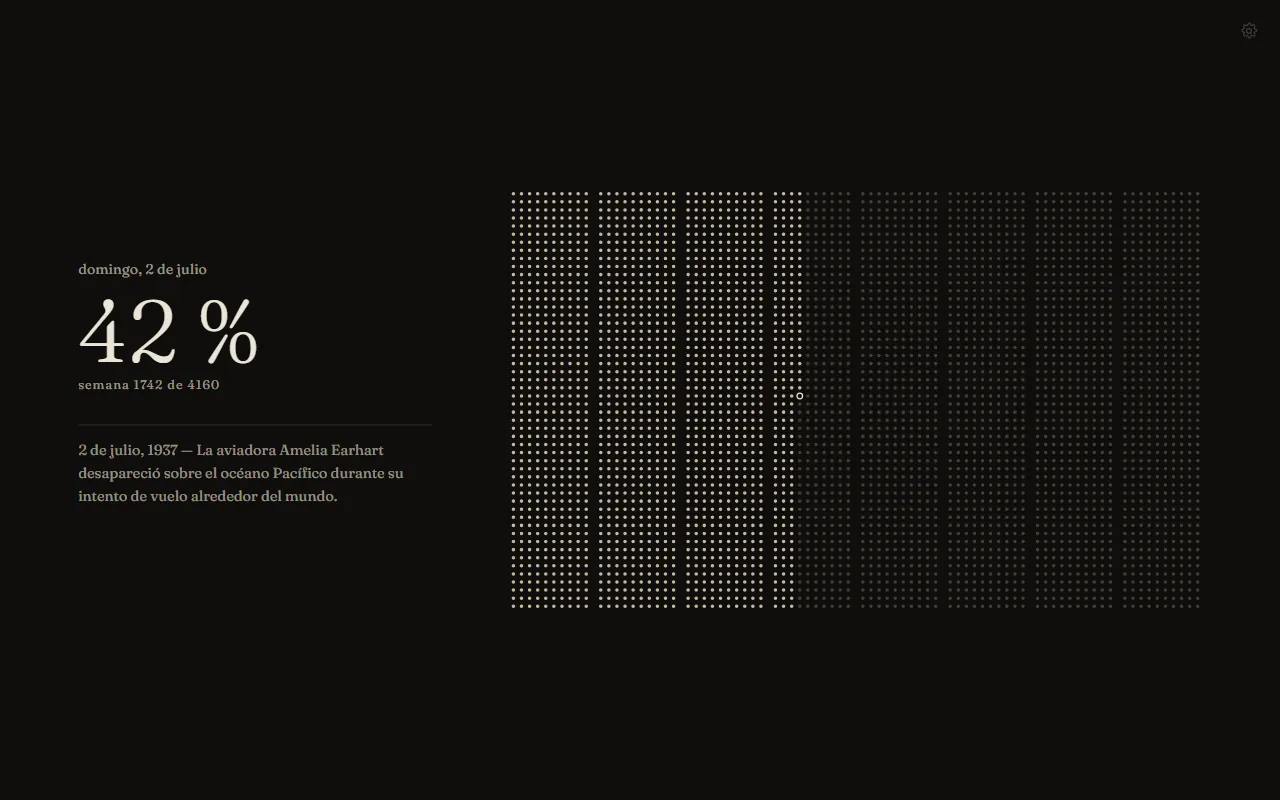
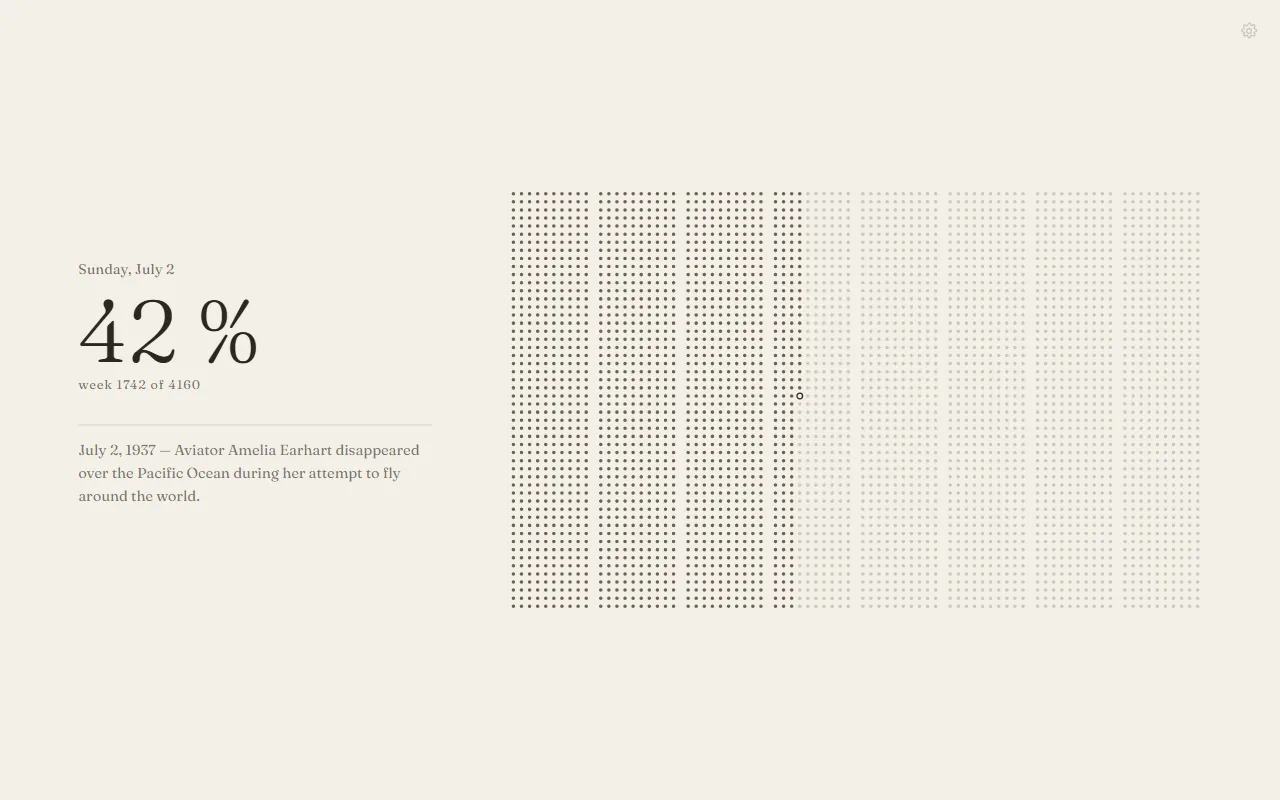
Extensión de Chrome publicada en la Chrome Web Store que reemplaza la pestaña nueva por una grilla con las semanas de la vida, calculada a partir de la fecha de nacimiento.
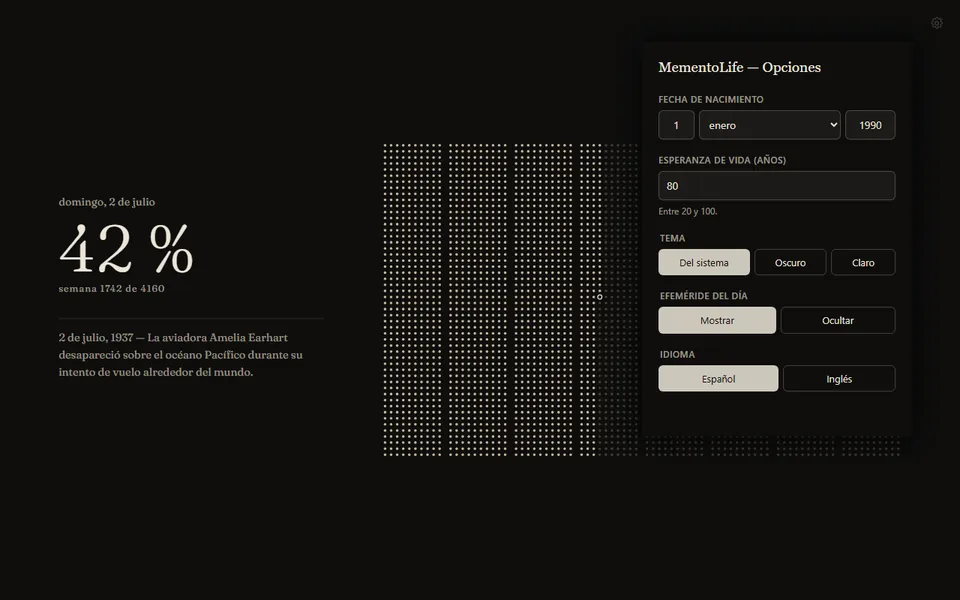
Tema claro, oscuro o del sistema, interfaz completa en 6 idiomas y una efeméride histórica para cada día del año. Ninguna conexión de red y un solo permiso (storage): la fecha de nacimiento se guarda sólo en el equipo.
TypeScript, sin frameworks ni bundler: ESM nativo compilado con tsc. Tests unitarios y de snapshots con Vitest, pruebas de extremo a extremo con Playwright sobre la extensión empaquetada y CI con GitHub Actions.
3 trazados
Stack
- TypeScript
- Manifest V3
- SVG
- Vitest
- Playwright
- GitHub Actions
Qué hace
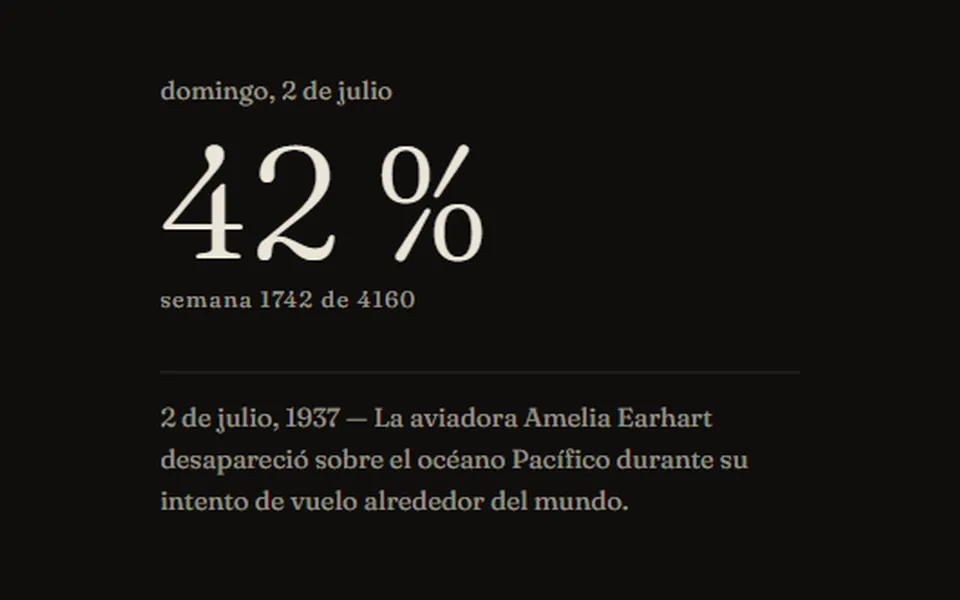
Cada punto es una semana. Las vividas se dibujan llenas, las que faltan apenas insinuadas, y un anillo marca la semana actual. La esperanza de vida se ajusta entre 20 y 100 años, y cada día muestra una efeméride histórica distinta, en los 6 idiomas, que se puede desactivar.
La grilla, en vivo
La grilla de esta página se dibuja con la misma técnica que la extensión: tres trazados SVG acumulados (pasado, futuro y anillo) en lugar de un elemento por celda. En la extensión, eso evita 4.160 elementos y baja el renderizado de 10,00 ms a 1,30 ms, medido contra la alternativa de un elemento por semana.
Capturas
Privacidad
- Ninguna conexión de red.
- Un solo permiso:
storage. - La fecha de nacimiento se guarda en
chrome.storage.local, nunca ensync: no viaja por la cuenta de Google.
Stack
| Capa | Tecnología |
|---|---|
| Lenguaje | TypeScript |
| Ejecución | Sin framework ni bundler: ESM nativo, tsc como único paso de build |
| Render | SVG generado por un núcleo puro: sin DOM, sin chrome.*, la fecha entra como parámetro |
| Pruebas | Vitest (unitarios y snapshots) + Playwright (extremo a extremo sobre el paquete real) |
| Empaquetado | Manifest V3, un solo permiso, sin service worker |
| CI | GitHub Actions en cada push |
Historia del proyecto
MementoLife empezó como una aplicación de Android que ponía la grilla en la pantalla de bloqueo. Funcionaba, pero MIUI y One UI ignoran en silencio los intentos de actualizar sólo la pantalla de bloqueo (setBitmap(..., FLAG_LOCK) no falla: no hace nada). En vez de romper una decisión de diseño del proyecto, se cambió de plataforma.
 Rugidos Fiestas Tandil · 2023 – actualidad · Sitio web comercial
Rugidos Fiestas
Sitio comercial de una empresa de eventos, mobile first y optimizado para búsquedas locales.
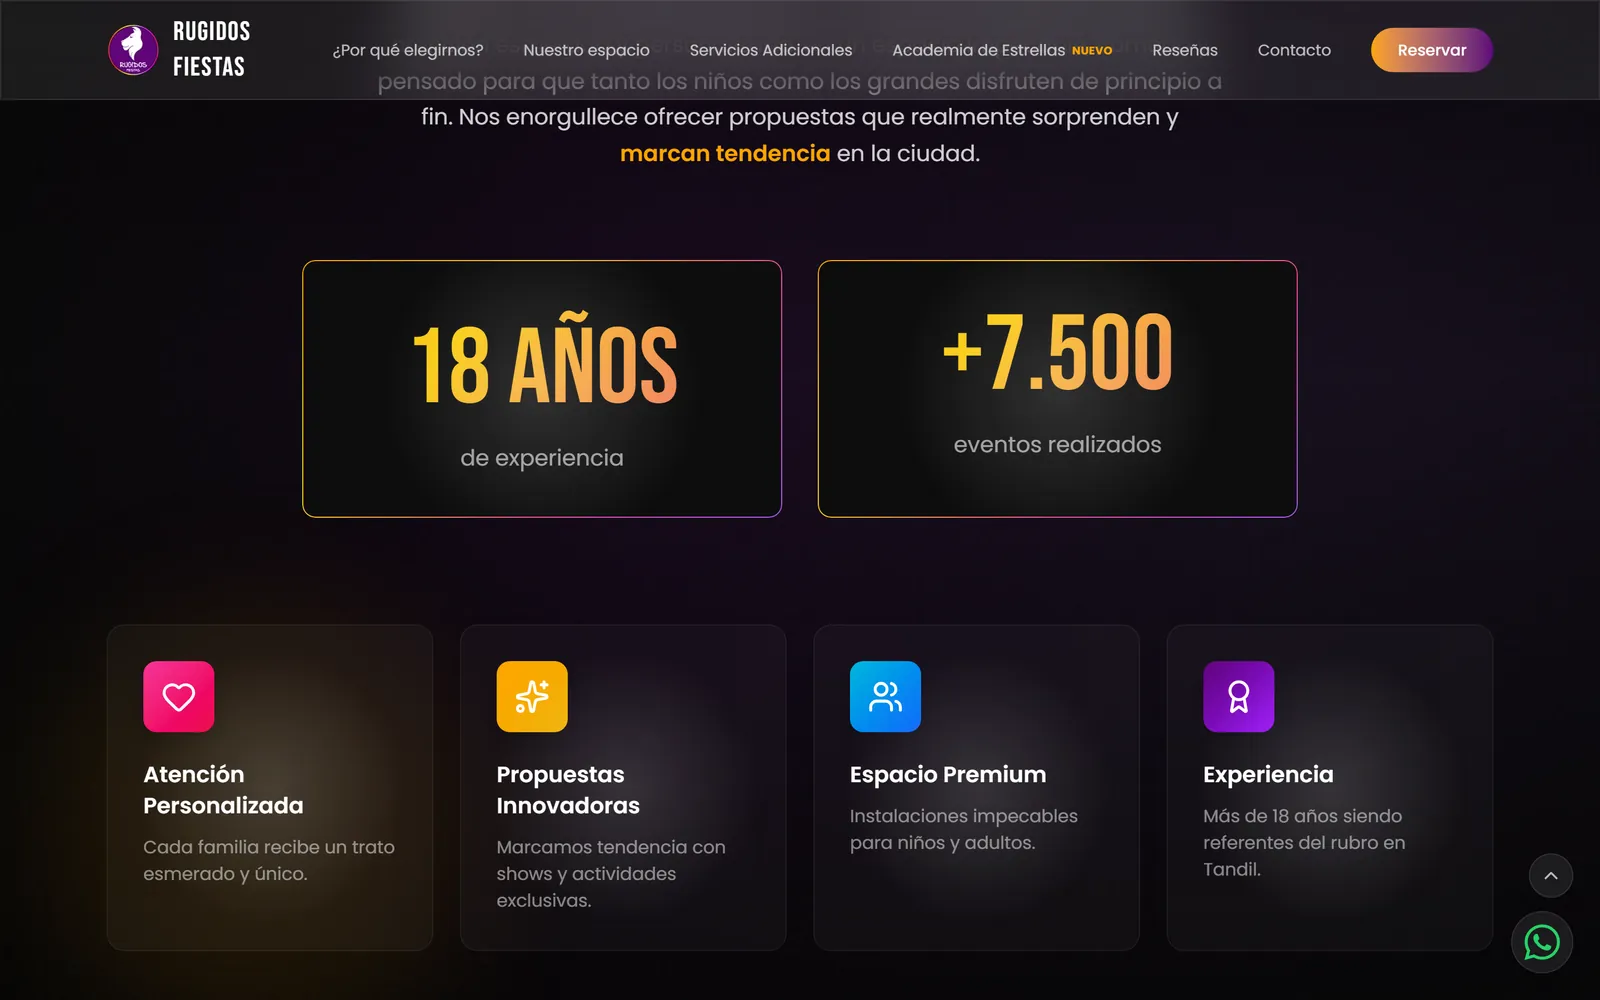
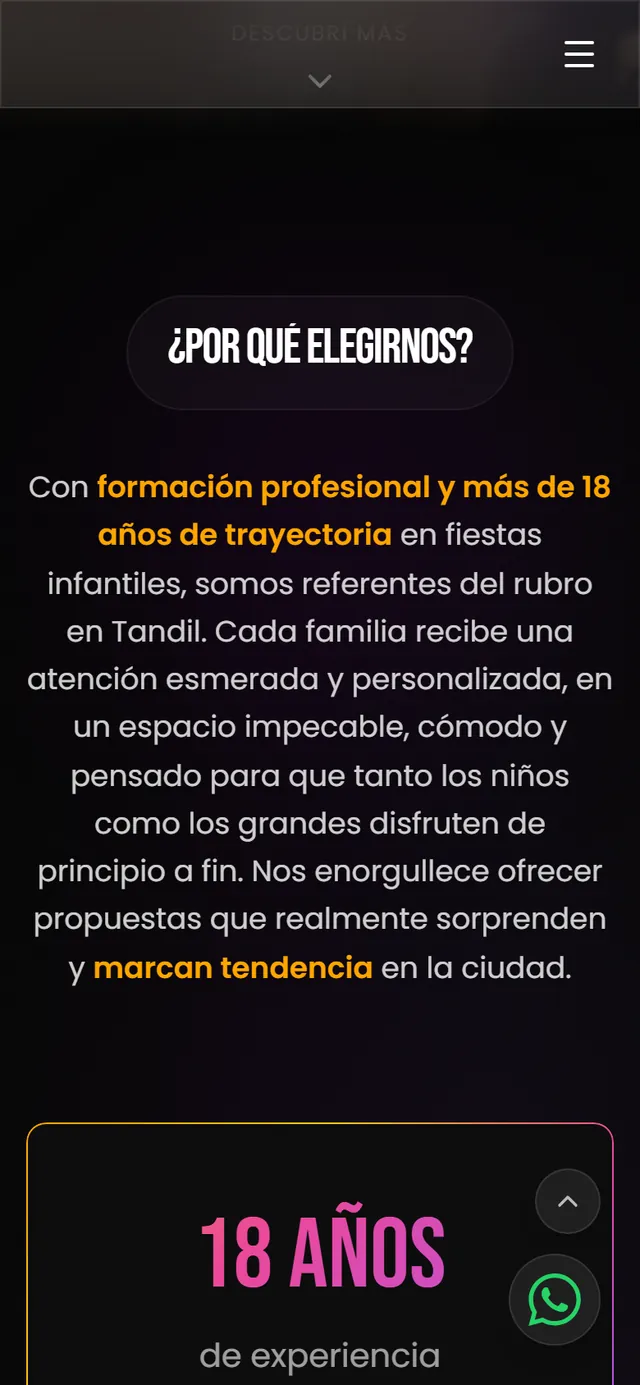
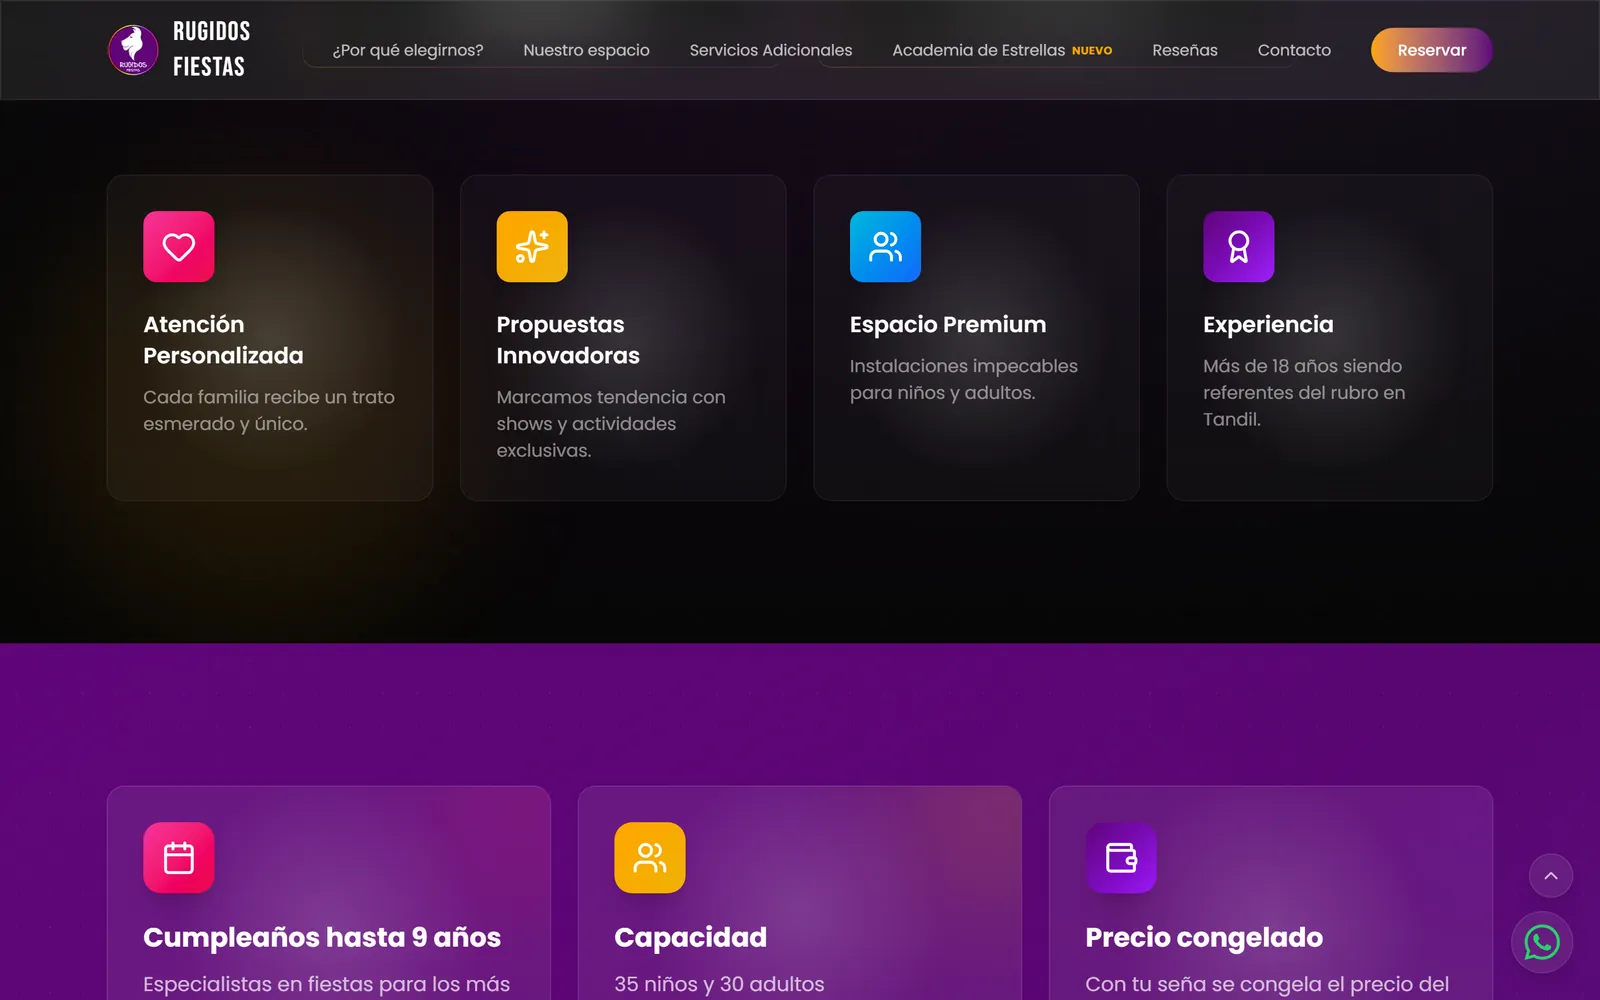
Diseñé, desarrollé y mantengo el sitio web comercial de la empresa, en producción. La versión actual está hecha con Next.js, TypeScript, Tailwind CSS y Framer Motion, con diseño UX/UI propio.
Los efectos pesados se desactivan en teléfonos para sostener la fluidez del scroll, el feed de Instagram y las reseñas son contenido local en lugar de widgets externos, y los datos estructurados ayudan en las búsquedas locales.
95 / 100
Stack
- Next.js
- TypeScript
- Tailwind CSS
- Framer Motion
- Lenis
- shadcn/ui
- Vercel
El sitio
El sitio es el canal comercial de Rugidos Fiestas Tandil, una PyME de eventos infantiles: tiene que mostrar el salón, los servicios y los extras, y llevar al visitante a una consulta por WhatsApp. Por eso se diseñó primero para el teléfono.
Secciones y funcionalidades
- Nuestro espacio: galería con lightbox navegable con teclado y una grilla con las características del salón.
- Academia de Estrellas: en escritorio, una máscara radial que sigue al cursor revela el look «superstar» debajo del casual; en teléfonos, un comparador antes/después que se arrastra con el dedo.
- Detección real de hover (
hover: hoverypointer: fine) en lugar de un corte por ancho, para no romper la experiencia en tablets táctiles. - Reseñas: resumen de Google Reviews y marquesinas con pausa manual, sin depender de widgets.
- Contacto: un botón de WhatsApp que abre la conversación con el mensaje ya escrito, la dirección del salón con su mapa de Google, las redes y una selección de publicaciones de Instagram.
Rendimiento
| Lighthouse | Móvil | Escritorio |
|---|---|---|
| Rendimiento | 95 | 99 |
| Accesibilidad | 96 | 96 |
| Buenas prácticas | 100 | 100 |
| SEO | 100 | 100 |
| LCP | 2,9 s | 0,8 s |
| CLS | 0 | 0 |
- Parallax, efecto 3D de las tarjetas, vidrio esmerilado y animaciones de entrada se desactivan en teléfonos, para que el contenido llegue antes y el scroll se mantenga fluido en equipos de gama media.
- El logo pasó de PNG (127 KB) a WebP (7 KB), y el recurso crítico del hero se pide con prioridad alta.
- Las fotos del salón y de los extras se procesaron en lote con Sharp: de ~15,6 MB a ~1,8 MB.
- El feed de Instagram y las reseñas de Google se sirven como contenido local: sin dependencias externas ni saltos de diseño mientras cargan.
Stack
| Capa | Tecnología |
|---|---|
| Framework | Next.js (App Router), TypeScript |
| Estilos y componentes | Tailwind CSS, shadcn/ui, Radix UI, Lucide |
| Movimiento | Framer Motion, Lenis (sólo en escritorio) |
| Deploy | Vercel, Vercel Analytics |
Primera versión
RugidosWebSite 2023 2023 – 2026
En producción desde 2023 hasta ser reemplazada por la versión actual. HTML, CSS y JavaScript sin frameworks, con deploy automático a cPanel. Desarrollada sin asistencia de IA.
- HTML5
- CSS3
- JavaScript
 Freelance · mar. – abr. 2026 · Sitio institucional
Navkok Security Group
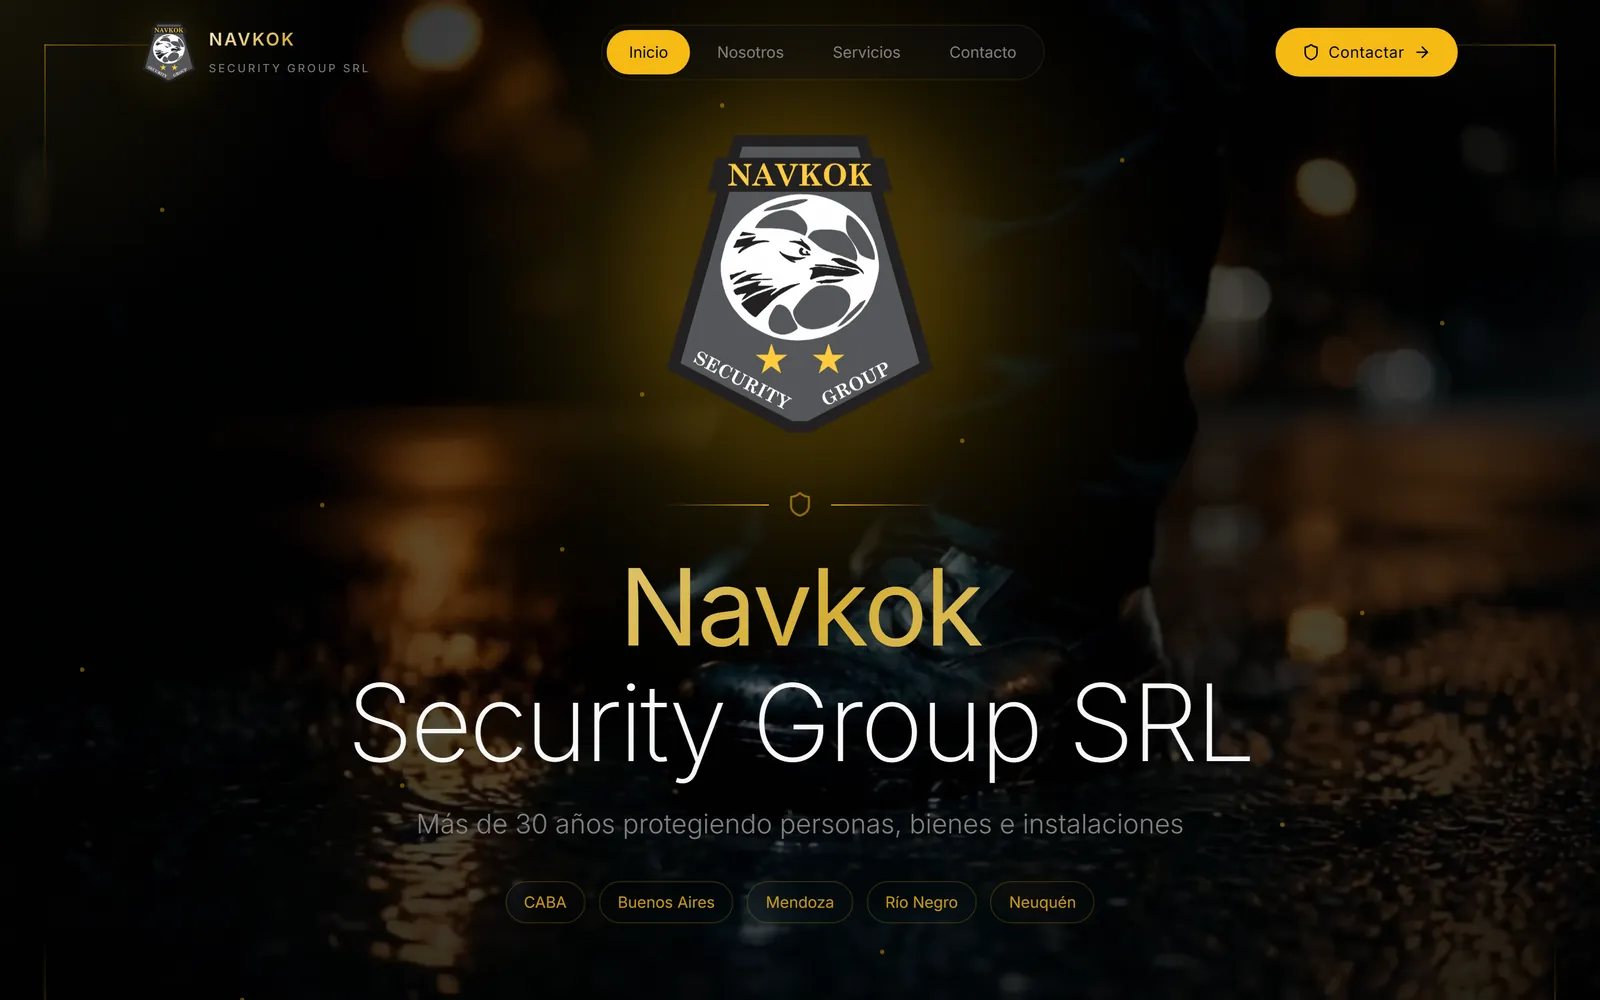
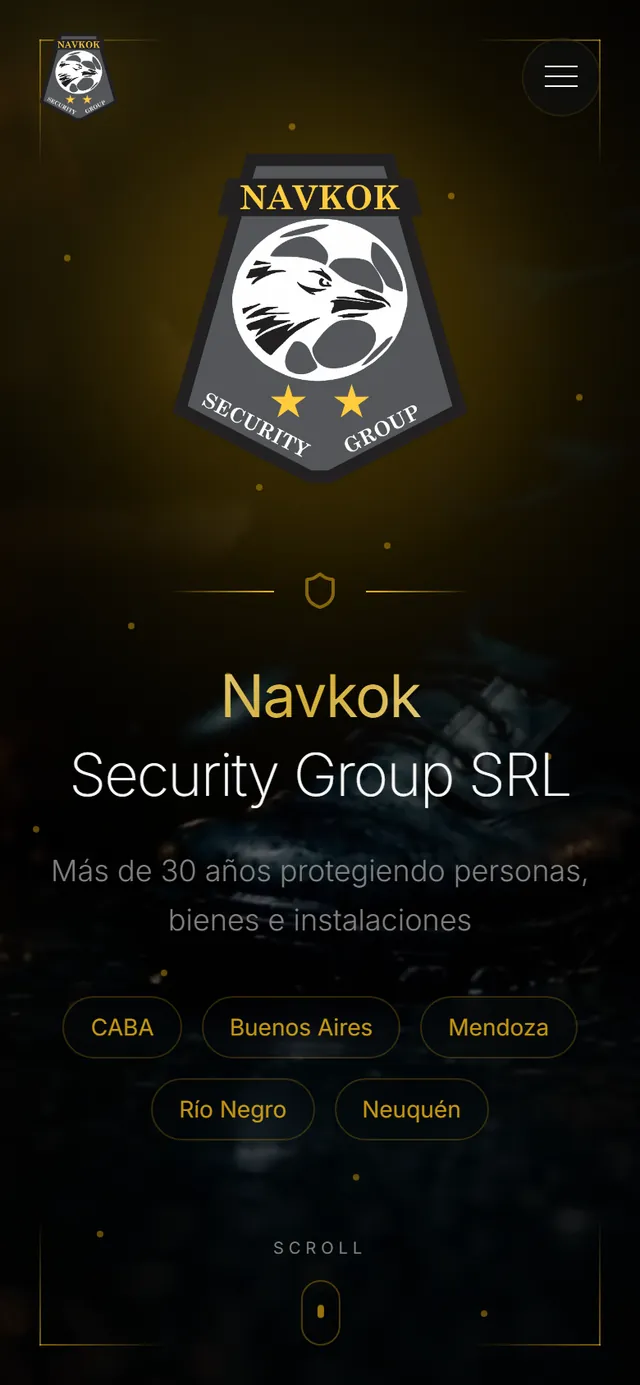
Rediseño completo del sitio institucional de una empresa de seguridad privada con más de 30 años de trayectoria y certificaciones ISO 9001, 14001 y 45001.
Proyecto freelance a mi cargo de principio a fin, desde la venta del proyecto hasta su finalización. Definí la arquitectura de información y el diseño UX/UI, redacté los textos institucionales y produje con herramientas de IA el contenido multimedia.
El diseño incluye el formulario de contacto y la sección «Trabajá con nosotros», donde un código QR se arma pieza por pieza al entrar en pantalla y lleva al formulario de postulación. Next.js, React, TypeScript y Tailwind CSS, con microanimaciones y diseño responsive.
Stack
- Next.js
- React
- TypeScript
- Tailwind CSS
Qué hice
- Relación con el cliente: venta del proyecto y trato directo durante todo el desarrollo.
- Contenido: definí las secciones del sitio y redacté los textos institucionales con el tono de la empresa.
- Contenido multimedia: producido con herramientas de IA y curado para la identidad de la marca.
- Formularios: el de contacto, con validación de campos, y el de postulación, al que lleva un código QR que se arma pieza por pieza al entrar en pantalla.
- Desarrollo: Next.js, React, TypeScript y Tailwind CSS, con microanimaciones y diseño responsive.
Diseño
Un sistema visual oscuro con acento dorado: la paleta, la tipografía y los componentes se definieron desde cero para transmitir la experiencia y las credenciales de la empresa. El contenido multimedia se optimizó con FFmpeg (compresión y recorte del video) y con Sharp (las imágenes, en lote).
 Rugidos Fiestas Tandil · 2025 · Aplicación de escritorio
FreeMagicMirror
Aplicación de fotomatón táctil en uso en el salón de Rugidos, distribuida como ejecutable portable para Windows.
Captura con cuenta regresiva animada, editor multitáctil con dibujo libre y stickers que se escalan y rotan con los dedos, y guardado automático en una galería local. Pensada para chicos: videos animados, transiciones suaves y controles grandes.
Python, Kivy y OpenCV. Un panel de administración oculto (cinco toques en una esquina) permite elegir cámara, orientación y monitor, y la aplicación corre en modo kiosco, a pantalla completa y sin bordes.
Stack
- Python
- Kivy
- OpenCV
- PyInstaller
- Docker
El recorrido en pantalla
- Inicio: un video en loop invita a tocar la pantalla.
- Pose: una animación sugiere poses para la foto.
- Cuenta regresiva y captura desde la cámara.
- Editor: dibujo libre con cinco colores, stickers que se escalan, rotan y mueven con varios dedos, y deshacer.
- Guardado en una galería local, con numeración incremental.
Decisiones técnicas
- La cámara se inicializa después de los videos, a 10 cuadros por segundo, para que la reproducción no se trabe.
- Videos decodificados con FFPyPlayer, integrado en Kivy, y exportación del lienzo completo (foto, dibujos y stickers) a PNG.
- Panel de administración oculto: detección de cámaras con OpenCV, orientación vertical u horizontal con ajuste de la ventana, y elección del monitor de salida.
- Rutas que detectan si la aplicación corre empaquetada con PyInstaller, para que el ejecutable encuentre sus recursos al copiarlo a otro equipo.
Distribución
Ejecutable portable (.exe) para Windows, sin dependencias externas, publicado en los Releases del repositorio, e imagen en Docker Hub para Linux.
Sobre mí
Desarrollo productos de software completos, desde el diseño hasta la puesta en producción, con foco en backend e inteligencia artificial aplicada. Tengo experiencia en proyectos de principio a fin, propios y freelance, con clientes y usuarios reales, con Python, React y Next.js, PostgreSQL y APIs REST.
Sobre la base que me da la carrera de Ingeniería de Sistemas (lógica de programación, análisis matemático y diseño de algoritmos), trabajo de forma autodidacta con tecnologías actuales, que aplico en proyectos propios con el código publicado. Lo combino con la gestión operativa de una PyME, donde sumo conocimientos de administración de empresas, producto y manejo de equipos.
Domino la IA aplicada al trabajo y a soluciones de producto: forma parte de mi proceso de desarrollo y de los productos que construyo. Las decisiones de producto, diseño y arquitectura son propias.
- Ubicación
- Argentina · Trabajo remoto
- Idiomas
- Español (nativo) · Inglés (B2)
- Ciudadanía
- Argentina e italiana (pasaporte de la UE)
- Formación
- Ingeniería de Sistemas · UNICEN · 2022 – actualidad
- Certificación
- Scrum Fundamentals Certified (SFC) · VMEdu · 2024
Experiencia
Rugidos Fiestas Tandil
PyME de eventos · Tandil, Argentina
- Desarrollador de Softwaresep. 2023 – actualidad
- Responsable de Operacionessep. 2019 – actualidad
- Diseñé, desarrollé y mantengo el sitio web comercial de la empresa, en producción: primera versión en 2023 y rediseño integral en 2026, con diseño UX/UI propio.
- Desarrollé FreeMagicMirror, una aplicación de fotomatón táctil que se usa en eventos.
- Gestiono la operación diaria: organización de los eventos, optimización de procesos internos y mejoras del modelo de servicio, parte de ellas implementadas con software propio.
SeViVe
Estudio de pilates (franquicia) · Canning, Buenos Aires
- Desarrollador Full Stack Freelancedic. 2025 – jun. 2026
- Desarrollé como único programador una aplicación de reservas y gestión con más de 200 usuarios, desde la definición de requisitos con el cliente hasta la puesta en producción: reservas con control de concurrencia, créditos con vencimiento, turnos fijos y panel de administración.
- Finalizado el desarrollo, continúo a cargo del soporte, la administración del servidor y las actualizaciones solicitadas por el cliente.
Navkok Security Group SRL
Empresa de seguridad privada · Argentina
- Desarrollador Web Freelancemar. 2026 – abr. 2026
- Rediseñé el sitio institucional, desde la venta del proyecto hasta su finalización: arquitectura de información, diseño UX/UI, textos institucionales y contenido multimedia producido con herramientas de IA.